TLDR
- Claude lit d’abord le ticket et la PR : Il vérifie la description, les critères d’acceptation, les commentaires et les changements de code avant de lancer le test.
- Il vérifie que le changement est bien déployé : Claude s’assure que le bon code est dans le bon environnement avant de lancer le test.
- Thunders teste comme un vrai utilisateur : Le test s’exécute dans un vrai navigateur, avec de vraies pages, des clics et des assertions.
- Pas de test ? Claude en crée un : Il peut transformer les étapes de reproduction d’un bug en test Thunders.
- Le test reste lié au ticket : Vous pouvez ainsi le relancer lors des prochaines releases, sans devoir tout retester depuis zéro.
- Le verdict est accompagné de preuves : Claude aide à faire la différence entre un vrai problème produit, un problème de test ou un incident temporaire lié à l’environnement.
Chaque équipe d'ingénierie a une colonne où les tickets attendent. Le code est mergé, la pull request est au vert, et le ticket reste là jusqu'à ce que quelqu'un trouve le temps de prouver qu'il fonctionne vraiment.
Nous avons décidé d'arrêter d'attendre. Notre équipe confie désormais toute cette colonne à Claude et Thunders. Un agent Claude prend en charge chaque ticket, tous en parallèle. Chaque agent lit le ticket, vérifie le code et teste la modification via Thunders dans un vrai navigateur, comme le ferait un utilisateur.
Voilà à quoi ressemble le test logiciel avec Claude lorsqu'il est connecté à l'application, au lieu de se limiter à lire du code ou à générer des scénarios de test. Claude comprend ce qui a changé, trouve les bonnes vérifications, crée un test quand il en manque un et s'appuie sur Thunders pour valider la modification dans le produit en fonctionnement. Thunders fournit la couche de tests de bout en bout qui fait tourner l'application dans un vrai navigateur.
Quelques minutes plus tard, chaque ticket a un verdict, accompagné des preuves qui le justifient.
Cet article explique comment fonctionne ce workflow, ce qu'il détecte et ce que nous avons appris en testant 13 tickets à la fois avec Claude et Thunders.
Pourquoi « mergé » ne veut pas dire « fonctionnel » ?
Une pull request au vert vous dit que les tests unitaires passent. Elle ne vous dit pas que le correctif fonctionne dans le produit.
Entre les deux se glisse une longue liste de choses qui déraillent en conditions réelles. Le correctif est mergé dans la mauvaise branche. Le déploiement a échoué sans que personne ne s'en aperçoive. Le code fonctionne, mais uniquement derrière un feature flag désactivé. Le bug est corrigé sur le parcours nominal et se produit toujours sur la page que le client utilise vraiment.
C'est là que le test QA avec Claude devient plus utile qu'une simple revue de code confiée à Claude. Le logiciel doit encore être exercé dans l'environnement où le client l'utilisera. Thunders est conçu pour les tests de bout en bout : la vérification porte sur le produit en fonctionnement, pas seulement sur le code.
La vérification manuelle détecte ces problèmes, mais elle est lente et ne passe pas à l'échelle. Quelqu'un doit lire le ticket, retrouver la pull request, vérifier le déploiement, ouvrir l'application, reproduire le bug d'origine et confirmer qu'il a disparu.
Multipliez cela par un sprint complet de tickets et vous perdez des jours. Et la vérification n'a lieu qu'une fois. À la release suivante, personne ne la relance.
À quoi ressemble le test logiciel avec Claude et Thunders ?
Pour chaque ticket, un agent Claude suit les mêmes étapes :
- Lire le ticket : parcourir la description, les critères d'acceptation, les commentaires et les pull requests liées.
- Vérifier que le code est bien là : confirmer que la modification est mergée dans la branche déployée sur l'environnement, que la CI est passée et que le déploiement a réussi.
- Choisir les tests : identifier les tests Thunders existants qui couvrent la fonctionnalité concernée.
- Écrire un test quand il n'en existe pas : transformer les étapes de reproduction du bug en nouveau test Thunders, avec préparation, actions, assertions et nettoyage.
- Exécuter le test comme un vrai utilisateur : lancer le test avec Thunders dans un vrai navigateur, sur l'environnement cible.
- Analyser les preuves : examiner les résultats de chaque étape, les captures d'écran et la télémétrie de l'application pour distinguer les vrais échecs d'incidents comme une micro-coupure réseau.
- Rendre un verdict : classer le ticket comme prêt, pas prêt ou en attente d'une décision humaine, avec la raison et les preuves à l'appui.
Les agents travaillent en parallèle : une colonne entière de tickets prend à peu près autant de temps qu'un seul.
C'est ce qui change la donne pour l'automatisation des tests avec Claude. Au lieu de cantonner Claude à la génération de scripts ou à la suggestion de scénarios de test, l'agent participe à une boucle qui commence par un ticket et se termine par des preuves issues de l'application en fonctionnement. Pour les équipes qui veulent intégrer ce même flux à leur processus de livraison, Thunders peut aussi exécuter les tests via des intégrations CI/CD.
Que détecte réellement l'automatisation des tests avec Claude ?
Les bugs qui n'existent que dans un vrai navigateur : les tests unitaires vérifient qu'une fonction renvoie la bonne valeur. Les utilisateurs, eux, n'appellent pas de fonctions. Ils cliquent sur des boutons dans des iframes, font défiler des grilles qui n'affichent que les lignes visibles et cliquent sur des éléments discrètement masqués par une popup. Une page simulée ne voit rien de tout cela. Un test Thunders, si : il lit la page, agit dessus et vérifie ce qu'il voit, comme le ferait une personne.
Les correctifs à moitié livrés : un changement de configuration jamais appliqué. Un déploiement qui ne s'est pas exécuté. Une fonctionnalité qui ne marche que lorsqu'un flag est activé. Claude vérifie ensemble le code, le déploiement et l'application en fonctionnement, pour que « terminé dans la pull request » et « terminé dans le produit » veuillent enfin dire la même chose.
Un périmètre modifié en silence : quand un correctif laisse de côté une partie de ce que demandait le ticket, le verdict le signale et indique qui doit valider. L'écart est visible avant la release, pas après qu'un client l'a découvert.
Sans cela, chacun de ces cas arriverait en production et reviendrait sous forme de ticket de support.
Que deviennent les tests après la release ?
C'est là que le gain de temps se cumule.
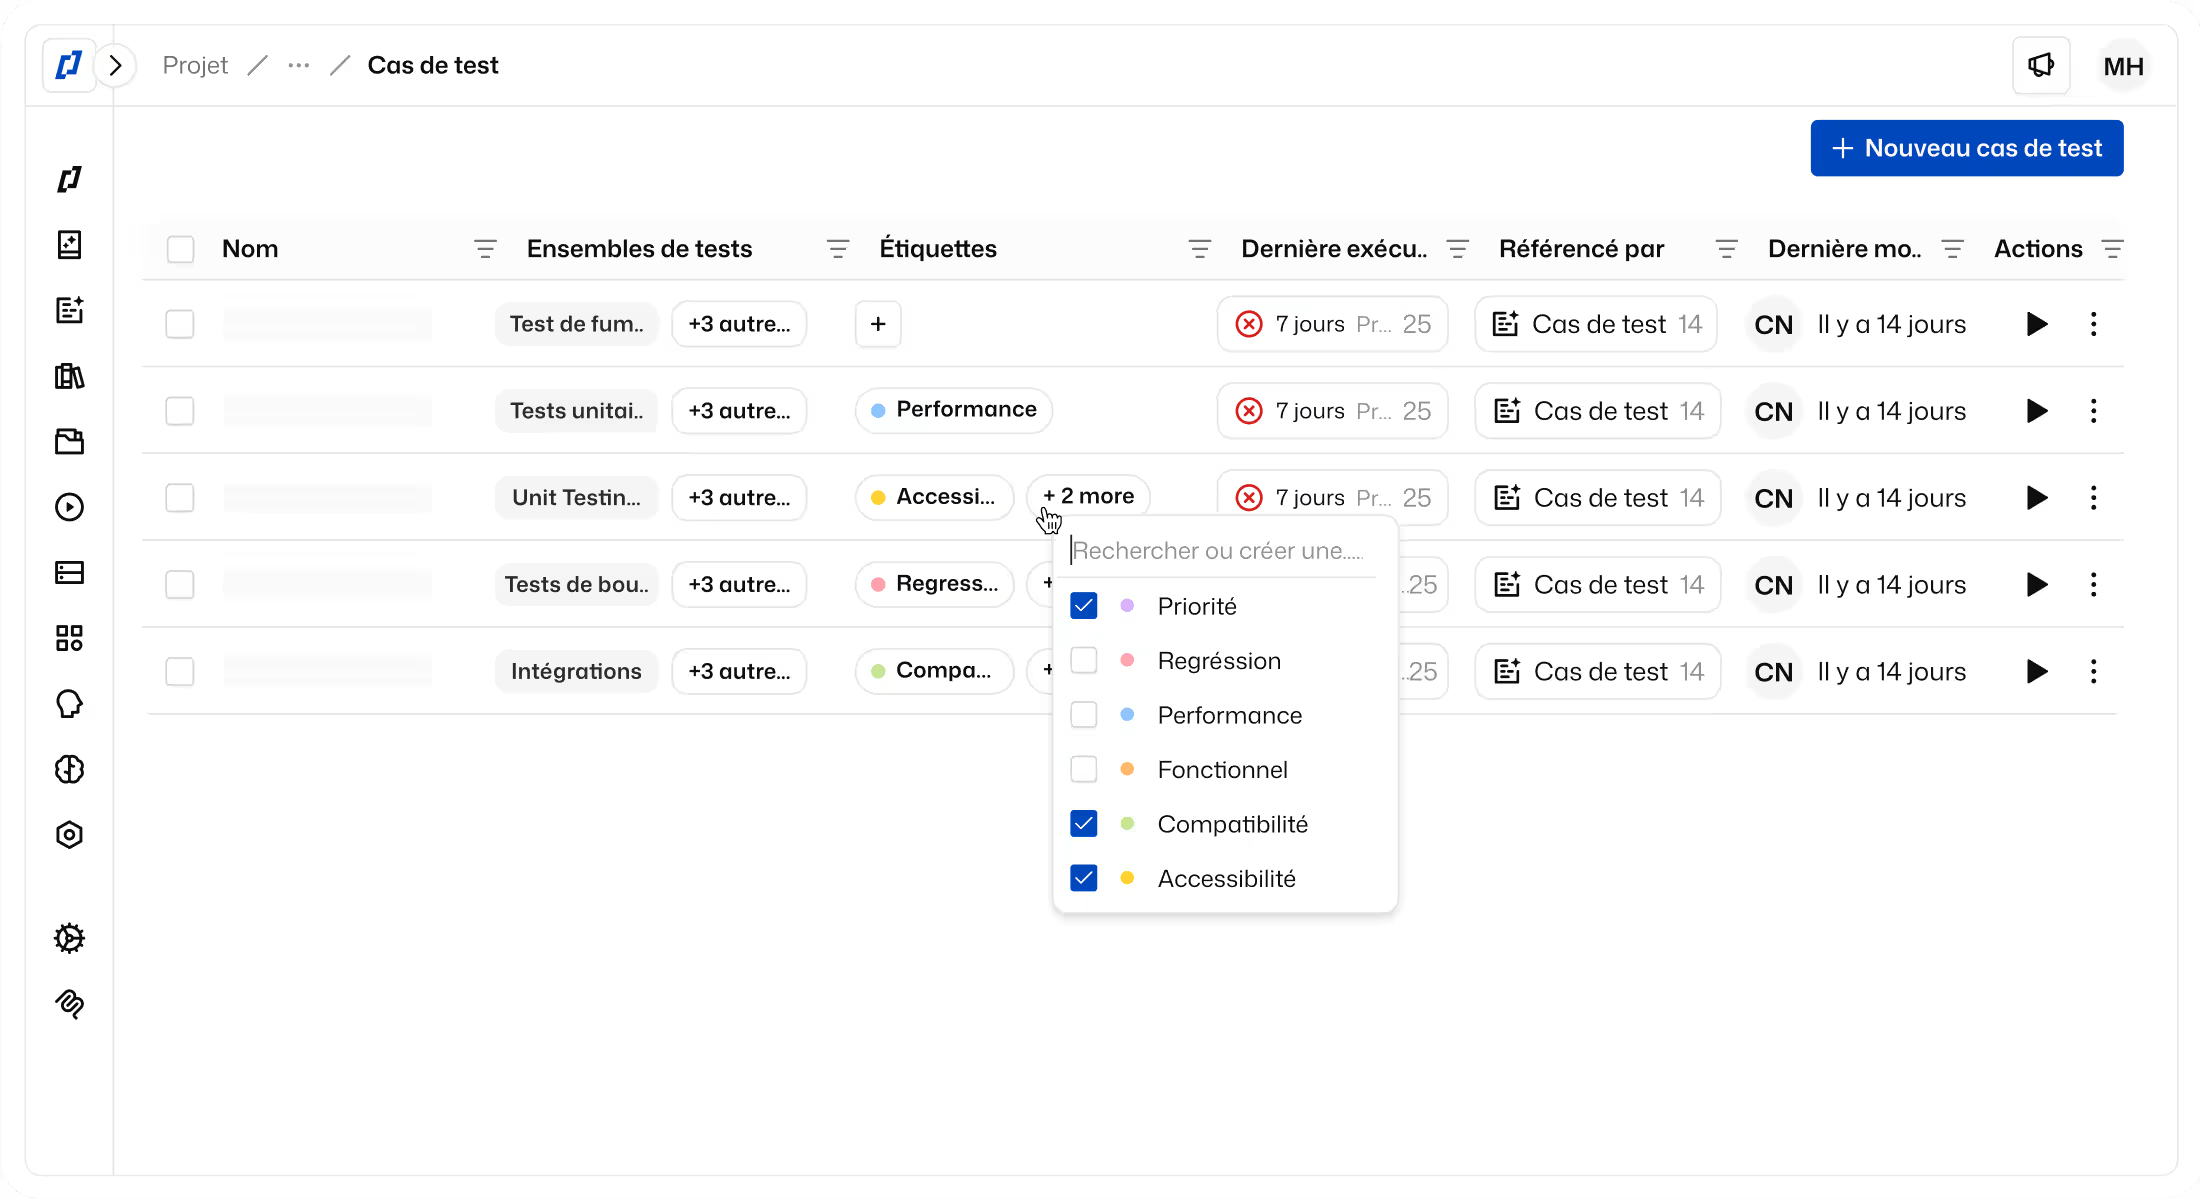
Chaque test écrit par Claude est lié à son ticket. La prochaine fois que quelqu'un livre une modification autour de ce code, le test est relancé. Puis la fois suivante aussi. Une vérification ponctuelle devient ainsi une gestion des tests réutilisable, qui reste rattachée à la modification qu'elle devait protéger.
Un bug n'est pas vérifié une fois puis oublié. Il devient un contrôle permanent qui garantit que le correctif, et chaque amélioration construite par-dessus, continue de fonctionner.
Au fil du temps, votre suite de régression se construit à partir des vrais bugs corrigés par votre équipe, et non d'un plan de test rédigé une fois puis jamais mis à jour. Et comme Thunders propose des tests auto-adaptatifs qui suivent les évolutions de l'interface, cette suite ne se transforme pas en chantier de maintenance.
Qui gagne du temps, et comment ?
Les développeurs : ils ne sont plus interrompus pour faire la démonstration de leur propre correctif. Ils mergent, et le verdict arrive avec les preuves : quel test a tourné, sur quoi il a cliqué et ce que montrait la télémétrie. En cas d'échec, le rapport précise s'il s'agit d'un bug produit, d'un problème de test ou d'un environnement instable. Thunders fournit aussi une analyse des échecs pour aider les équipes à comprendre ce qui a cassé et à agir sur la base des preuves.
Les ingénieurs QA : ils ne recliquent plus les mêmes parcours à chaque release. Ils consacrent davantage de temps à ce qui demande du jugement : les edge cases, les tests exploratoires et la revue des tests rédigés par Claude.
Les product managers : ils obtiennent une réponse claire à la question « est-ce qu'on peut livrer ? » pour chaque ticket, en langage clair. Quand la réponse est « décision humaine requise », le rapport indique précisément quelle décision est en attente et qui en est responsable.
Les clients : ils subissent moins de régressions. Le correctif qu'ils ont demandé reste en place le mois suivant, parce qu'un test le protège désormais à chaque release.
Claude remplace-t-il les humains dans les tests QA ?
Non. Certaines questions ne relèvent pas d'une machine : un périmètre réduit est-il acceptable, une release peut-elle partir avec un écart connu, une fonctionnalité doit-elle sortir maintenant ou attendre ?
Claude repère ces questions et les soumet aux bonnes personnes. Il n'y répond à la place de personne.
Les verdicts sont aussi transparents sur leurs propres limites. Quand un test prouve seulement que rien d'autre n'a cassé, le rapport le dit, au lieu de déclarer le correctif validé.
Cette distinction compte dans le test QA avec Claude. L'automatisation n'est utile que si chacun comprend ce que les preuves démontrent réellement.
Comment cela se traduit-il pour l'entreprise ?
L'enchaînement est simple :
- Chaque modification est testée comme par un vrai utilisateur avant la release : le produit en fonctionnement est vérifié, au lieu de s'appuyer uniquement sur des tests au niveau du code.
- Chaque correctif obtient un test relancé sur les prochaines releases : le contrôle de non-régression reste rattaché à la modification d'origine.
- Moins de bugs et de régressions atteignent les clients : les problèmes sont détectés avant de devenir des incidents de production.
- Les clients disposent d'un produit plus fiable : moins de régressions, c'est moins de tickets de support et moins de perturbations après les releases.
- L'équipe passe plus de temps à construire : développeurs et QA consacrent moins de temps à répéter des vérifications manuelles.
Des releases plus rapides et plus sûres ne sont pas qu'une victoire pour l'ingénierie. Elles contribuent à ce que les clients gardent confiance à chaque nouvelle version.
La place de Thunders dans le test logiciel avec Claude
Pour comparer plus en détail les deux approches, consultez notre comparatif Thunders vs Claude.
Thunders est la partie du workflow qui se comporte comme un vrai utilisateur. Il exécute des tests de bout en bout dans de vrais navigateurs, permet à chacun de décrire un test en langage naturel et maintient les tests fonctionnels quand l'interface évolue.
Claude se charge de la lecture, des vérifications et de la rédaction autour. Thunders fournit l'exécution et les preuves issues de l'application en fonctionnement.
Ensemble, ils transforment votre colonne de test : ce n'est plus une salle d'attente, mais une étape qui prend quelques minutes.
Vous pouvez commencer comme nous : prenez les tickets qui attendent dans votre colonne de test et laissez Claude et Thunders les tester comme le feraient vos utilisateurs.
Créez un compte Thunders gratuit ou réservez une démo pour le voir sur votre propre application.