
TLDR
Un ingénieur QA IA superintelligent ne lancerait pas davantage de tests. Il changerait les questions posées, le moment où on les pose et le degré de confiance qu'on peut accorder aux réponses. Cette expérience de pensée décrit huit traits d'un tel testeur : il lit chaque changement avant sa mise en production, se souvient de chaque bug jamais remonté, explore les parcours que personne n'a cartographiés, décide de ce qu'il ne faut pas tester, sait quand tester, sait à quoi ressemble un résultat « correct », a du goût et montre son travail.
Nous suivons ensuite une semaine de release en 2030, montrons comment chaque trait correspond à ce que les agents de Thunders font déjà aujourd'hui, et proposons trois habitudes que toute équipe QA peut adopter dès maintenant.
Si la QA peine à devenir superintelligente, ce n'est pas faute d'intelligence : le vrai frein a toujours été la maintenance.
La QA peut-elle devenir superintelligente ? La plupart des réponses commencent par le modèle, les benchmarks, l'architecture. C'est le mauvais point de départ.
Partons plutôt du métier. Imaginez un ingénieur QA sans aucune limite : jamais fatigué, jamais en retard sur le backlog, jamais tenté d'ignorer un test flaky un vendredi à 17 h 45. Il se souvient de chaque ticket Jira depuis l'époque où l'entreprise tenait en trois personnes et un tableau blanc. Il a lu chaque ligne écrite par votre équipe, livrée ou cassée.
Que ferait-il vraiment de différent ?
La réponse évidente, « lancer plus de tests », est presque toujours fausse. Plus de tests, c'est ce qu'on obtient avec un script plus rapide. Un testeur superintelligent changerait quelles questions sont posées, à quel moment elles le sont, et à quel point vous pouvez vous fier à la réponse. Ce passage de scripts qui exécutent à des agents qui décident, c'est exactement ce qu'on désigne par test agentique ou test autonome.
En bref. Un ingénieur QA superintelligent ferait huit choses dont un script est incapable : lire chaque changement avant sa mise en production, se souvenir de chaque bug jamais remonté, explorer les parcours que personne n'a cartographiés, décider de ce qu'il ne faut pas tester, savoir quand tester, savoir à quoi ressemble un résultat « correct », avoir du goût, et montrer son travail. Les agents de Thunders en font déjà une première version, pour chacun des huit. Nous montrons où.
1. Il lit chaque changement avant sa mise en production
Un ingénieur QA humain découvre ce qui a changé au stand-up. Ou dans les release notes. Ou quand un test passe au rouge à 23 h.
Un testeur superintelligent lirait chaque pull request dès son ouverture. Pas pour faire la revue du code (vos devs seniors en débattent déjà largement). Pour poser une seule question : qu'est-ce que ce changement pourrait casser, là où personne ne regarde ?
Prenez un refactoring CSS du composant bouton partagé, un champ renommé dans l'API de checkout, ou un feature flag activé pour 10 % des utilisateurs. Chacun touche des parcours qu'aucun ticket ne mentionne. Le testeur remonte du diff jusqu'aux parcours utilisateur concernés et les teste avant le merge, pas après l'incident. Les éditeurs d'outils appellent une version limitée de ce principe « test impact analysis ». La version superintelligente raisonne sur les parcours produit, pas seulement sur les dépendances entre fichiers.
Le vrai changement porte donc sur le moment, plus que sur la vitesse. Le test passe de « une fois que c'est construit » à « pendant que ça se décide ».
2. Il se souvient de chaque bug jamais remonté
Chaque équipe a son bug qui revient. Le sélecteur de date qui casse dans un nouveau fuseau horaire. Le code promo qui se cumule alors qu'il ne devrait pas. Quelqu'un l'a corrigé il y a deux ans, a écrit un test, puis le test a été supprimé lors d'un nettoyage parce qu'« il était flaky ».
Dans la plupart des équipes, la mémoire de la QA tient dans la tête de deux ou trois personnes. Quand elles partent, le contexte part avec elles, en général après deux semaines de préavis et une documentation de passation à moitié rédigée.
Un testeur superintelligent conserverait tout l'historique : chaque ticket, chaque exécution en échec, chaque cause racine. Quand un nouveau changement touche une zone déjà sensible, personne n'a besoin de rappeler « attention, ce module nous a déjà posé problème ». Il a déjà vérifié.
C'est toute la différence entre une suite de tests et un testeur. Une suite sait ce qu'on lui a dit. Un testeur sait ce qui s'est passé.
3. Il explore les parcours que personne n'a cartographiés
Les plans de test décrivent l'application telle que l'équipe l'imagine. Les utilisateurs vivent l'application telle qu'elle est vraiment.
Ils appuient sur le bouton retour en plein paiement. Ils collent un emoji dans un champ de numéro de téléphone. Ils ouvrent le même formulaire dans deux onglets et soumettent les deux. Rien de tout cela ne figure dans le plan de test, parce que personne ne s'est demandé ce que ferait ici une personne un peu chaotique.
Un testeur superintelligent se poserait cette question en permanence. Il parcourrait l'application comme le font les vrais utilisateurs, repérerait les embranchements et suivrait ceux que personne n'a scriptés. Et quand il trouverait quelque chose d'intéressant, il le transformerait en couverture permanente, pour qu'un edge case découvert une fois reste couvert.
Le test exploratoire a toujours été le plus précieux et le plus difficile à passer à l'échelle. On ne recrute pas dix mille testeurs curieux.
4. Il décide de ce qu'il ne faut pas tester
Cela semble contre-intuitif : un testeur plus intelligent lance moins de tests.
La plupart des suites de régression grossissent sans fin. Personne ne supprime de test, parce que personne ne veut être celui qui a retiré le test qui aurait détecté la panne. Résultat : la suite prend 40 minutes, puis 90, puis finit dans un job nocturne dont plus personne ne lit le rapport.
Un testeur superintelligent traiterait la couverture comme un budget. Pour chaque release, il identifie ce qui est réellement à risque au vu des changements. Après une modification des paiements, il martèle le checkout. La page de paramètres que personne n'a touchée depuis six mois a droit à un rapide smoke test. Du test basé sur les risques, autrement dit, appliqué à chaque commit plutôt qu'à chaque trimestre.
Les ingénieurs QA seniors travaillent déjà ainsi. Ils ne peuvent simplement pas le faire pour chaque commit, et personne ne les paie pour essayer.
5. Il sait quand tester
La plupart des équipes testent à un seul rythme. Soit tout tourne à chaque merge et le pipeline prend une heure, soit tout tourne à 2 h du matin et personne ne lit le rapport.
Un testeur superintelligent fonctionnerait sur plusieurs horloges à la fois. Chaque commit reçoit les vérifications utiles pour ce changement. Chaque nuit, les parcours critiques tournent de bout en bout : inscription, connexion, checkout, remboursements. Chaque semaine, la longue traîne a droit à un passage complet, y compris les pages d'administration que personne n'ouvre. Chaque release reçoit la suite complète et tous les personas. Et il ne s'arrêterait pas au déploiement. Quand un prestataire de paiement modifie discrètement la réponse de son API un dimanche, le testeur le remarque, parce que la production est le plus grand environnement de test dont vous disposerez jamais et qu'il ne l'a jamais quittée des yeux.
Il ajusterait aussi ces rythmes lui-même. Un parcours qui a cassé trois fois le mois dernier passe d'hebdomadaire à quotidien. Une page stable depuis un an descend à une vérification mensuelle. Le test devient un signal continu que l'on consulte à tout moment, plutôt qu'une barrière franchie une fois par sprint.
Tout tester en permanence paraît idéal jusqu'à ce qu'arrive la facture de calcul. Savoir quand tester, c'est ce qui rend « tout » abordable.
6. Il sait à quoi ressemble un résultat « correct »
C'est la partie difficile. Les chercheurs l'appellent le problème de l'oracle : un test ne détecte un bug que si quelque chose lui indique quelle était la bonne réponse. Le sujet a sa propre littérature de synthèse (Barr et al., IEEE Transactions on Software Engineering, 2015), et c'est la raison pour laquelle « l'IA écrit les tests » ne représente que la moitié du travail.
Les scripts tirent leur oracle des assertions. Quelqu'un a écrit « le total doit être égal à 42,50 » et le script le vérifie. Si personne n'a écrit l'assertion, le bug passe sans encombre. La page se charge, le bouton répond, le test passe, et le client voit le mauvais prix.
Un testeur superintelligent tirerait son oracle de l'intention. Il lirait le ticket, la spécification, le comportement précédent et la logique propre au produit, puis se demanderait : est-ce que cela a du sens ? Un total de panier qui ne correspond pas à ses lignes. Un e-mail de confirmation envoyé avant la validation du paiement. Un message de « succès » sur un formulaire qui n'a rien enregistré.
Aucune assertion n'a échoué dans ces trois cas. Un bon testeur humain les détecterait pourtant tous les trois, parce qu'il sait à quoi sert la fonctionnalité. C'est d'ailleurs l'essentiel de ce que signifie l'intelligence en QA. Le reste, c'est de l'exécution.
7. Il a du goût
Fonctionner ne veut pas dire être bon. Un formulaire peut passer tous les tests et donner malgré tout envie de jeter son ordinateur par la fenêtre.
Aujourd'hui, ce jugement repose sur la personne qui, par hasard, regarde l'écran avant la release. Un designer repère le bouton mal aligné sur la page de tarifs. Un PM remarque que le checkout demande désormais sept clics au lieu de quatre. La plupart des semaines, personne ne regarde, et la première personne à s'en apercevoir est un client qui laisse un avis à une étoile.
Un testeur superintelligent aurait des opinions. Il regarderait un écran et dirait « quelque chose cloche » : la modale dont le bouton de fermeture disparaît sur un ordinateur 13 pouces, le message d'erreur gris sur fond gris clair, la carte avec 12 px de marge intérieure quand tout le reste en a 16. Il ressentirait la friction comme une personne. Trois indicateurs de chargement d'affilée. Une étape de confirmation qui pose deux fois la même question. Un parcours où il faut revenir en arrière pour trouver le seul bouton utile.
Et il ne s'arrêterait pas à « quelque chose ne va pas ». Il expliquerait pourquoi cela gêne, au regard de votre design system et de ce que les utilisateurs attendent clairement. Parfois, il dirait simplement « c'est moche » (et parfois, il aurait raison).
C'est l'écart entre « ça marche » et « ça paraît juste ». Presque aucun test automatisé ne le voit aujourd'hui. Un testeur doté de goût le verrait.
8. Il montre son travail
Plus un testeur agit en autonomie, plus une question compte : pouvez-vous faire confiance à une coche verte ?
Un script basique qui échoue, c'est agaçant. Un agent intelligent qui valide alors qu'il ne devrait pas, c'est dangereux. Un faux positif ne crée pas de ticket. Il crée une release.
Un testeur superintelligent ne se contenterait donc jamais d'un simple « réussi ». Il dirait ce qu'il a fait, ce qu'il a vu et pourquoi il a conclu que la fonctionnalité marche, captures d'écran et étapes à l'appui. En cas de doute, il le dirait et laisserait la décision à un humain plutôt que de deviner avec aplomb.
On oublie souvent ce trait quand on imagine la superintelligence. Vous ne voulez pas d'un testeur que vous ne pouvez pas remettre en question. Vous en voulez un qui rend la remise en question facile.
Une semaine de release en 2030
Une liste de traits, on l'approuve facilement d'un hochement de tête. Il est plus intéressant de les voir à l'œuvre en même temps. Imaginez donc une semaine de release dans quelques années.
Lundi, un PM rédige trois phrases décrivant un nouveau parcours de remboursement. Avant même qu'une ligne de code existe, le testeur les a lues, comparées à deux ans de tickets de support, et a signalé un manque : que deviennent les points de fidélité lors d'un remboursement partiel ? Personne n'y avait pensé. La spécification évolue, et le bug n'est jamais écrit.
Mardi, des agents de code écrivent l'essentiel du code. C'est le point que beaucoup ratent. Quand produire du logiciel devient bon marché, le goulot d'étranglement se déplace vers la capacité à savoir s'il est correct. Le testeur travaille donc face à l'agent de code comme un partenaire d'entraînement : tout ce que l'un propose, l'autre tente de le casser, en quelques minutes plutôt qu'en quelques sprints.
Mercredi, pas de plan de test. Le testeur lance dix mille utilisateurs simulés sur une copie de la production. L'un est impatient. Un autre a une connexion 3G instable à Lagos. Un autre utilise un lecteur d'écran, et un dernier rembourse deux fois la même commande, par pure malice. Le testeur conserve les 40 parcours qui lui ont appris quelque chose et écarte le reste.
Jeudi, la release est déployée auprès de 5 % des utilisateurs, et le testeur continue d'observer. Il repère que les remboursements en francs suisses prennent quatre secondes de plus que les autres, et ouvre un correctif avant que quiconque ne se plaigne.
Vendredi appartient aux humains. L'équipe QA consacre la matinée à une seule question remontée par le testeur : ce comportement est-il un bug ou une décision métier ? Voilà le métier en 2030. Moins écrire des tests, davantage décider de ce que signifie la qualité pour ce produit et apprendre au système à tenir cette ligne.
Dans ce monde, la suite de tests cesse d'être un empilement de scripts. Elle devient la description la plus fidèle de la façon dont votre produit est censé se comporter : une spécification vivante, écrite et tenue à jour par ce qui la vérifie.
L'ingénieur QA cesse d'être le dernier rempart avant la release. Il devient la personne qui définit ce que « bon » veut dire, pour les agents qui construisent comme pour ceux qui vérifient.
Trois habitudes à adopter dès maintenant
Pas besoin d'une superintelligence pour emprunter ses habitudes. Trois des huit fonctionnent avec une équipe humaine et un budget normal.
Écrivez l'intention, pas seulement les assertions. Quand vous ajoutez un test, écrivez au-dessus une phrase qui dit à quoi sert la fonctionnalité (« un remboursement ne peut jamais dépasser le montant payé »). Les relecteurs repèrent bien plus vite une mauvaise assertion quand l'intention est juste à côté, et c'est exactement ce dont un agent aura besoin plus tard.
Donnez une mémoire à votre suite. Associez chaque test de régression au ticket qui l'a motivé. Ne supprimez rien de ce qui est associé. Quand un test est retiré pour cause de flakiness, le lien vers le ticket oblige quelqu'un à marquer une pause, et cette pause est tout l'intérêt du trait n° 2.
Budgétez la couverture par changement, pas par sprint. Choisissez cinq parcours critiques. Lancez-les à chaque merge. Lancez tout le reste chaque nuit. Puis, une fois par mois, regardez quels tests nocturnes n'ont jamais échoué, et demandez-vous à quoi ils servent. La suite raccourcit, et personne ne regrette ce qui a disparu.
Ce que les agents de Thunders font déjà
L'essentiel, si l'on regarde la forme plutôt que l'échelle. Chacun des huit traits est un jugement que les agents de Thunders exercent déjà à chaque exécution.
| Trait | Ce que fait Thunders aujourd'hui |
|---|---|
| Lit chaque changement | Les agents s'exécutent dans votre pipeline CI/CD à chaque pull request : un changement est testé avant le merge, pas après l'incident |
| Se souvient de chaque bug | Chaque exécution est conservée, chaque échec est analysé par un triage IA qui distingue un bug produit d'un problème de test, et les bugs sont remontés dans votre outil de suivi selon les règles de votre équipe |
| Explore les parcours non cartographiés | Les AI Personas (QA, accessibilité, SEO, sécurité) rejouent le même parcours sous des angles différents et font ressortir ce qu'un script unique ne chercherait jamais, pendant que les tests s'auto-réparent quand l'interface évolue |
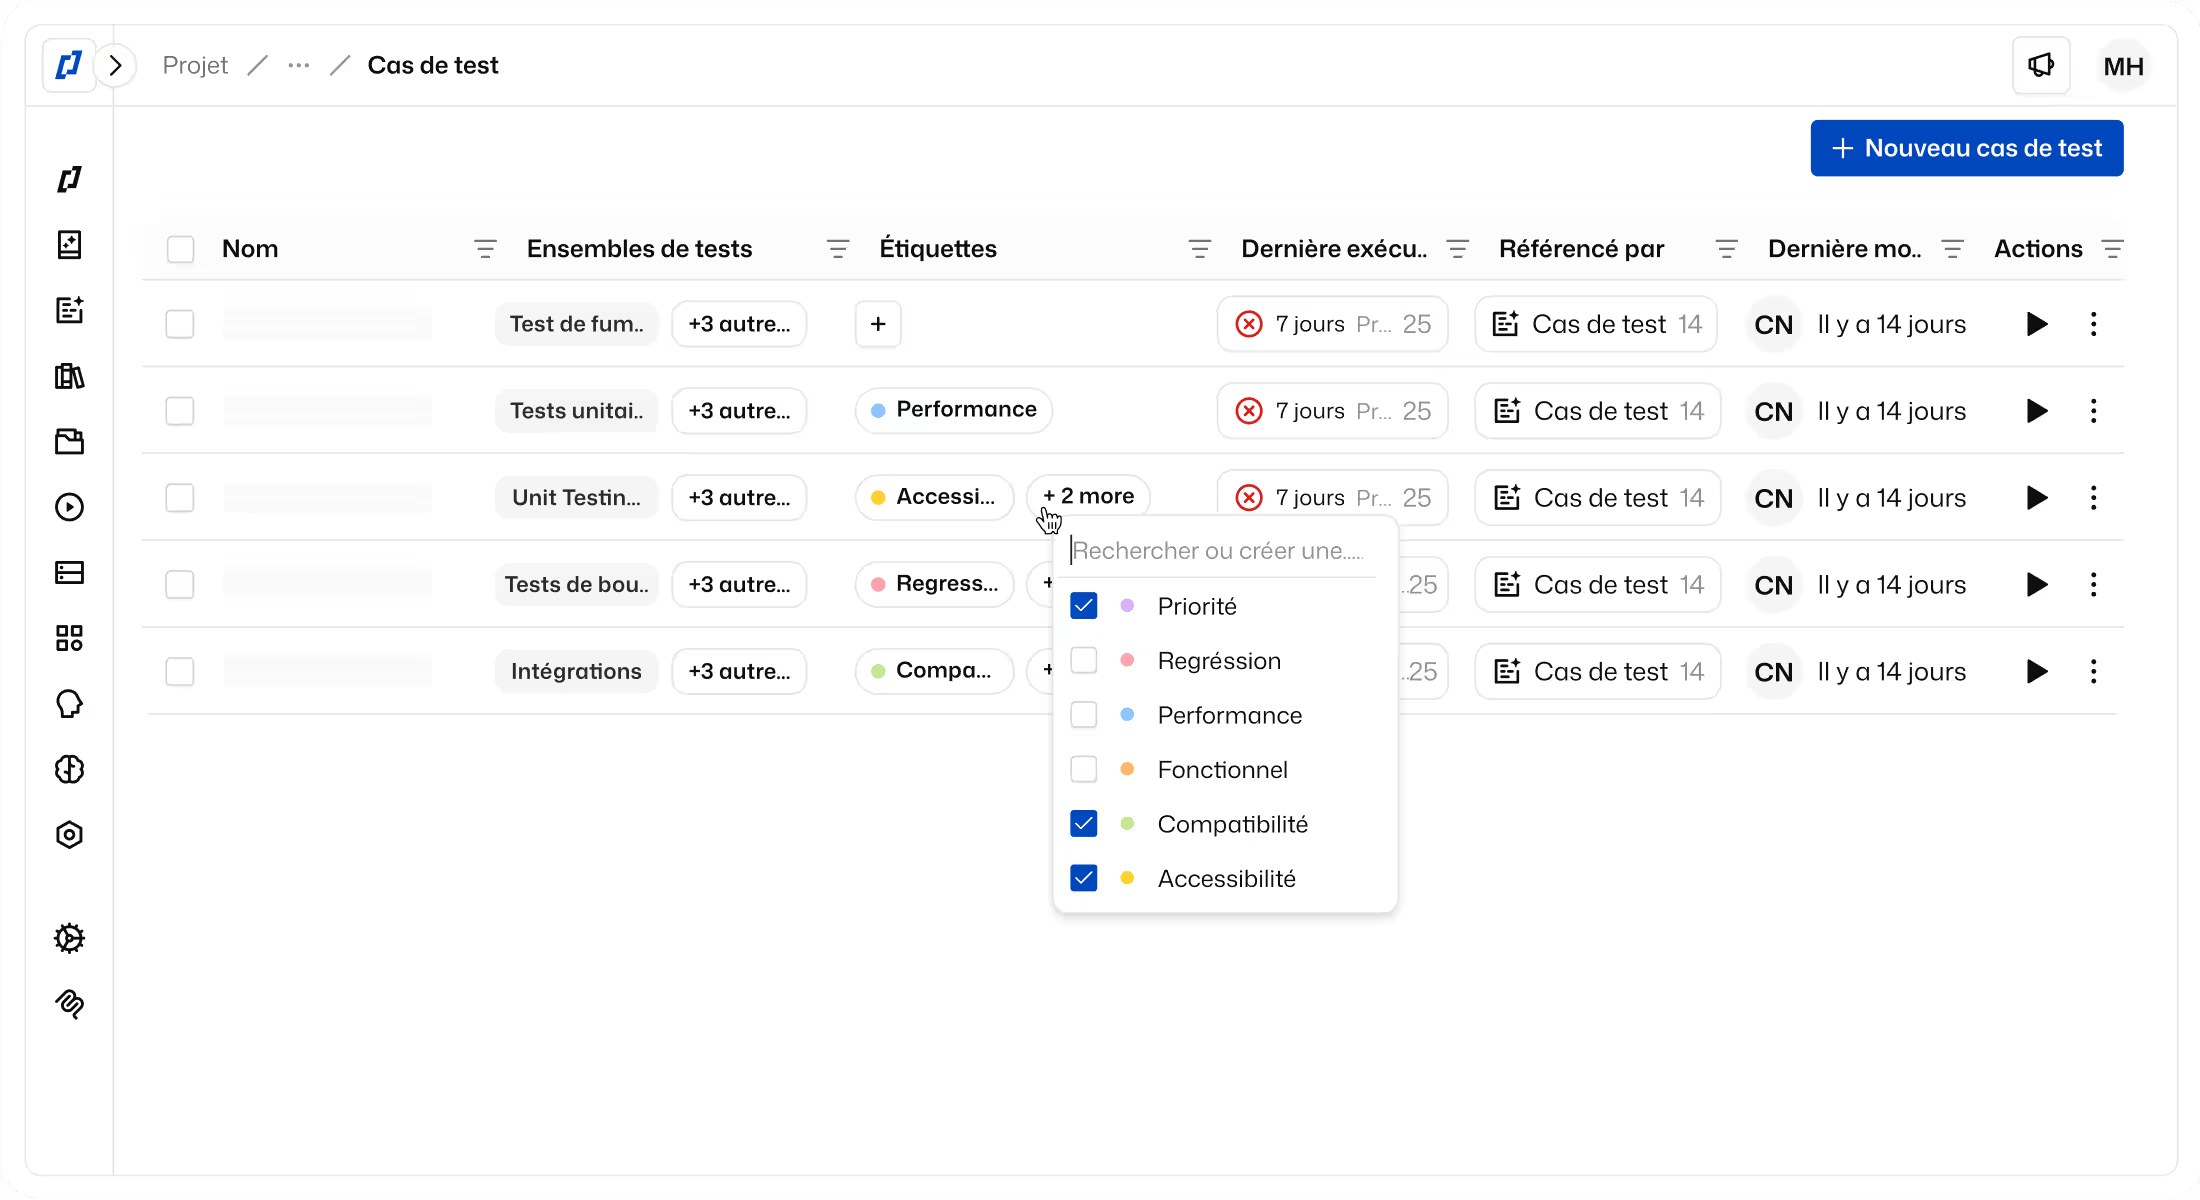
| Décide de ce qu'il ne faut pas tester | Les Test Sets et les labels permettent à chaque release de ne lancer que ce qui est à risque, et le coaching IA signale les étapes fragiles avant qu'elles ne gâchent une exécution |
| Sait quand tester | Les Test Sets tournent sur plusieurs horloges à la fois : à chaque déploiement, selon un planning (quotidien, hebdomadaire) ou à la demande |
| Sait à quoi ressemble un résultat « correct » | Les tests sont générés à partir de vos spécifications et de vos tickets Jira sous forme d'intention en langage naturel : l'agent vérifie à quoi sert la fonctionnalité, pas seulement qu'un bouton répond |
| A du goût | Le persona accessibilité signale des obstacles qu'un test fonctionnel laisserait passer, et les comparaisons visuelles repèrent les décalages de mise en page pour lesquels personne n'a écrit d'assertion |
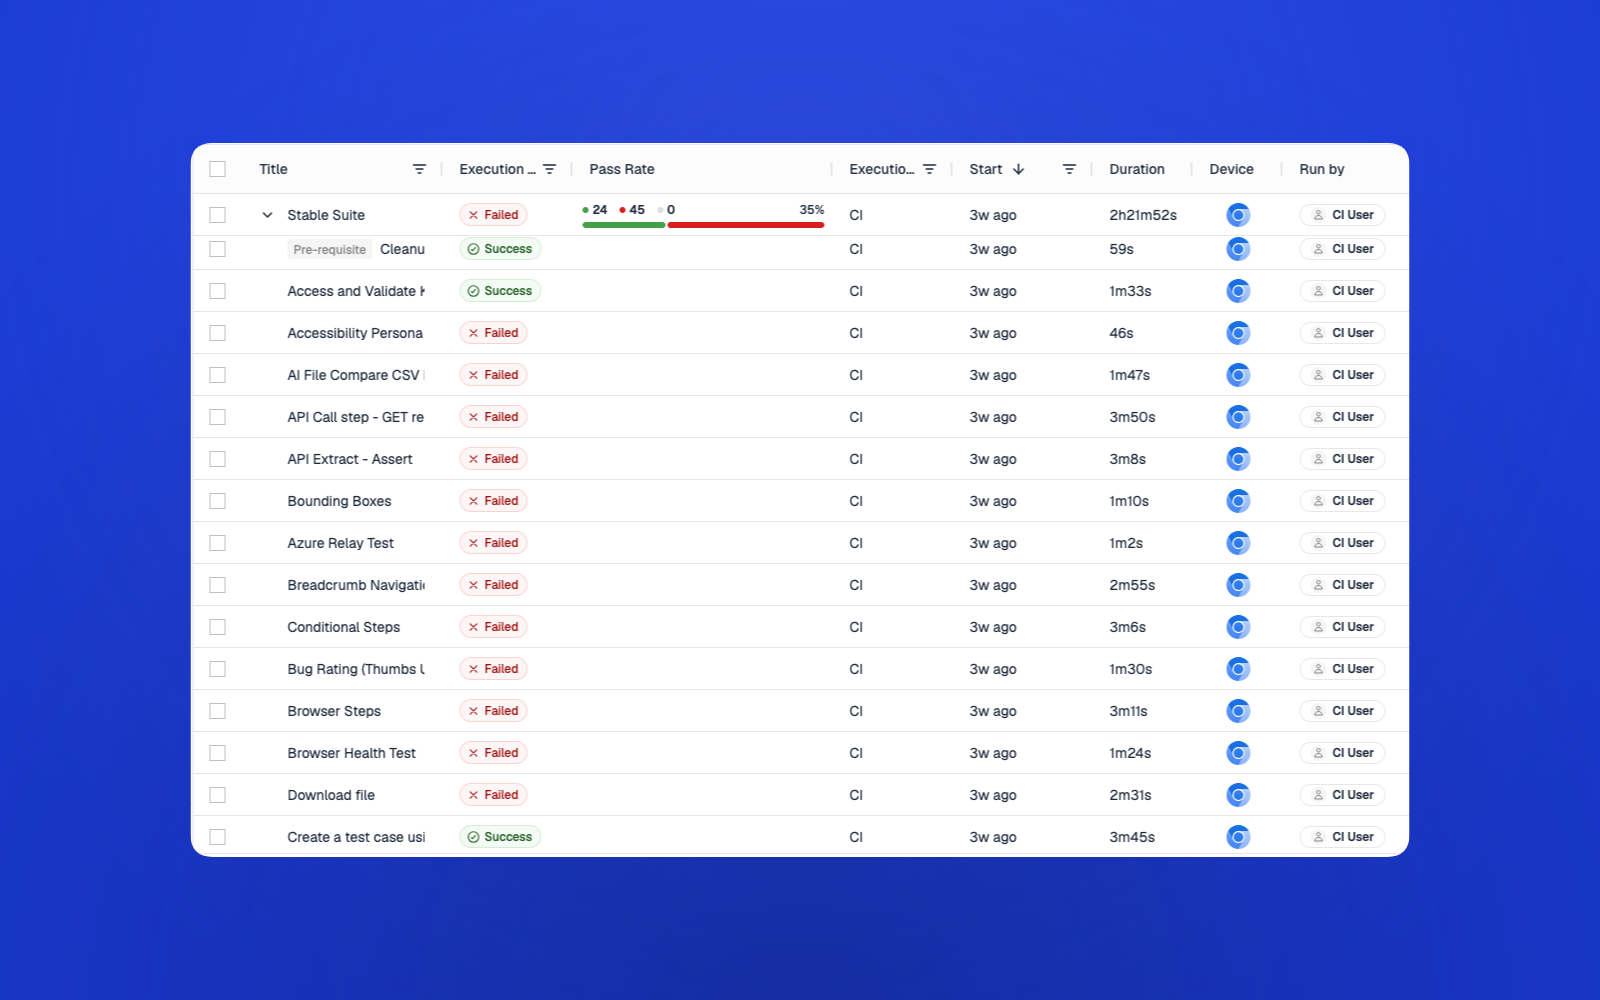
| Montre son travail | Chaque étape est accompagnée d'une capture d'écran, chaque exécution en échec explique pourquoi elle a cassé et comment corriger, et un humain peut vérifier ces preuves en quelques secondes |
C'est le pari sur lequel Thunders est construit : le passage des scripts aux agents compte davantage que n'importe quelle fonctionnalité isolée. Vous décrivez ce qu'il faut tester en langage naturel. Les agents écrivent les tests, les exécutent et les maintiennent quand votre interface change, sur les parcours de bout en bout, API et mobiles. Chaque exécution laisse des preuves qu'un humain peut vérifier en quelques secondes.
Les traits qui relèvent encore de la science-fiction (dix mille utilisateurs simulés, un testeur qui a un avis sur vos marges intérieures) sont précisément ce à quoi sert cette base. Un agent qui lit déjà l'intention plutôt que les sélecteurs progresse à chaque release qu'il teste. Un script qui casse chaque fois que quelqu'un renomme une classe CSS, jamais.
La question derrière la question
Alors, la QA peut-elle devenir superintelligente ?
Reprenez les huit traits. Aucun ne consiste à cliquer plus vite. Tous relèvent du jugement : ce qui a changé, ce qui compte, quand regarder, ce qui est correct, ce qui paraît juste, et à quel point vous en êtes sûr. Les grands ingénieurs QA ont toujours apporté ce jugement. Leur problème n'a jamais été l'intelligence. L'essentiel de leur semaine partait simplement dans le maintien des scripts en vie.
La meilleure question est peut-être de savoir où va l'intelligence de votre équipe : dans la qualité, ou dans la maintenance.
Les agents prennent en charge la maintenance. Votre équipe garde le jugement.
Envie de voir jusqu'où les agents sont allés ? Lancez votre premier test en langage naturel, gratuitement, ou réservez une démo en venant avec le parcours qui casse le plus souvent.