TLDR
- Le zéro code ne vaut que si une personne non technique peut créer, relire et modifier un test. Essayez l'outil sur un parcours de difficulté moyenne et repérez le moment où il réclame un selector ou un script.
- Dans Thunders, vous décrivez un scénario en langage naturel et AI Test Generation construit le test. Nous couvrons le web, iOS et Android, les API et le desktop, et un même test peut s'exécuter de bout en bout d'une plateforme à l'autre.
- Le self-healing réduit la maintenance, il ne la supprime pas. Le nôtre n'est pas une boîte noire : nous vous montrons chaque étape réparée, avec ce qui a changé.
- Jugez tout outil sur des preuves : parcours pris en charge, résultats des réexécutions, taux d'échec et historique de maintenance.
La plupart des outils qui se disent zéro code le restent jusqu'au premier cas difficile. Une liste déroulante exige un selector personnalisé. Une connexion exige une étape scriptée. Et la personne à qui l'on avait promis qu'elle pourrait écrire des tests rend le sujet à un développeur.
Si vous cherchez une solution zéro code pour le test applicatif automatisé, vérifiez deux points : qui, dans votre équipe, peut écrire et relire un test dès le premier jour, et qui le maintient en vie après la dixième release. Nous traitons les deux, et nous montrons comment nous y répondons dans Thunders.
Accès no-code et facilité d'utilisation
Nous avons conçu Thunders pour générer des tests automatisés à partir d'instructions en langage naturel. Vous décrivez le scénario à valider, par exemple un client existant qui se connecte, ajoute deux articles au panier et paie par carte, et AI Test Generation en fait un test exécutable, avec ses étapes, ses assertions et ses edge cases. Le test peut aussi partir d'une URL, ou d'un ticket Jira ou Linear. Aucun script à écrire, aucun framework à installer.
C'est ce que l'on appelle le « scriptless test automation », l'automatisation des tests sans script. Vous décrivez l'intention, Thunders se charge des clics.
Pour l'utiliser, il vous suffit de connaître votre produit. Créer un test, c'est connaître le parcours et ce qui doit être vrai à la fin. Relire un test, c'est lire ses étapes. Le modifier, c'est dire à Thunders AI ce qu'il faut changer, dans une conversation : ajuster une étape, ajouter une validation, retravailler le scénario. Nous vous recommandons de relire chaque test généré, et vous devriez exiger la même chose de tout éditeur, nous compris. Un test généré que personne n'a lu, c'est une supposition avec une coche verte à côté.
La frontière entre no-code et low-code se repère facilement. Confiez l'outil à un product manager, choisissez un parcours de difficulté moyenne, et observez. Les outils low-code proposent un enregistreur ou un éditeur visuel pour le cas simple, puis réclament un selector, un bout de JavaScript ou un fichier de configuration dès que le parcours contient une condition ou un tableau dynamique. Si quelqu'un doit ouvrir les outils de développement du navigateur, c'est du low-code, et les seules personnes capables d'écrire des tests redeviennent celles qui savaient déjà scripter.
Une réserve vaut pour tous les produits de cette catégorie, le nôtre compris. Brancher un pipeline CI, relier Jira ou pousser des builds mobiles depuis la CI via une API, c'est une configuration qu'un ingénieur fait une fois. Elle se situe autour des tests, pas à l'intérieur. Demandez à chaque éditeur où il place cette limite.
Un parcours de création de test est fiable quand vous pouvez le vérifier vous-même pendant un essai. Générez deux fois le même scénario et comparez les étapes. Vérifiez que les assertions testent le résultat, et pas seulement le chargement d'une page. Modifiez une étape en langage naturel, relancez, et lisez ce qui a changé.
Thunders est multiplateforme, dans un sens précis que vous pouvez vérifier. Nous testons les applications web sur Chromium, Chrome, Firefox, Safari et Edge. Nous testons les applications iOS et Android, qu'elles soient natives, hybrides ou WebView, y compris React Native et Flutter, sur de vrais appareils et sur émulateurs. Nous couvrons aussi les tests d'API et d'applications desktop. Vous pouvez également tester de bout en bout d'une plateforme à l'autre : un même test peut suivre un parcours qui commence sur le web, se poursuit dans l'application mobile et se vérifie via une API.
Fiabilité et maintenance dans la durée
Chez Thunders, nous utilisons les Self-Healing Tests pour absorber les changements qui, sinon, vous obligeraient à reprendre un test à la main. Le mécanisme mérite d'être compris, car le terme « self-healing » recouvre des réalités très différentes d'un éditeur à l'autre.
Dans Thunders, une étape vise une intention (« Cliquer sur le bouton de connexion ») et nous identifions l'élément correspondant grâce à plusieurs selectors à la fois : ID, classes, XPath, position et texte. Quand un bouton se déplace ou qu'un champ de formulaire change d'ID, le locator d'origine échoue et nous essayons les alternatives à l'exécution. Quand la mise en page bouge ou qu'un élément se charge tard, nous réessayons avec des attentes intelligentes. Quand une étape générée par l'IA demande une réparation plus profonde, Heal réinitialise l'étape et l'IA régénère ses actions à l'exécution suivante. Nous constatons que 95 % des changements d'interface sont absorbés à l'exécution. Vérifiez ce chiffre sur votre propre application.
Notre self-healing n'est pas une boîte noire. Nous vous montrons chaque réparation : l'étape réparée apparaît dans l'exécution, avec ce qui a changé. Vous pouvez les lire une à une et décider si le test s'est adapté à un changement d'interface sans conséquence ou s'il a masqué quelque chose qui aurait dû échouer. Tous les outils de self-healing ne vous montrent pas cela, alors posez la question avant d'acheter. Une réparation que vous ne voyez pas, c'est un test auquel vous ne pouvez plus vous fier.
Les deux fonctionnalités reposent sur l'IA, et notre documentation produit précise ce que cela recouvre : la génération à partir du langage naturel, d'URL et de tickets, et la réparation par selectors de repli, attentes et régénération. Nous ne prétendons pas que les tests n'auront plus jamais besoin de quelqu'un. Nous mettons en garde contre la fausse confiance, quand une réparation masque un vrai bug, et nous vous demandons de superviser et de valider les corrections. Vous pouvez le faire parce que nous vous montrons chaque réparation.
C'est ainsi, selon nous, qu'il faut lire toute la catégorie. Une description courante de l'automatisation des tests par l'IA promet de « réduire la maintenance et d'automatiser les tests web, mobiles et API ». Réduire est le mot juste. Avec le self-healing, la question de la maintenance n'est plus de savoir qui corrige les selectors, mais qui relit les réparations. Le travail est bien plus léger, et il lui faut quand même un responsable.
Pour comparer une approche fondée sur l'IA à une approche scriptée classique, mesurez les cinq mêmes points des deux côtés :
- Couverture. Comptez les parcours automatisés au bout de six semaines et notez qui les a écrits. Une suite scriptée est plafonnée par le temps des ingénieurs qui savent scripter.
- Analyse des échecs. Mesurez le temps qu'il vous faut, après un échec, pour savoir s'il s'agit d'un bug, d'un test cassé ou de l'environnement. Dans Thunders, le persona IA qui a exécuté l'étape vous indique ce qu'il attendait et où se situe l'écart, et un clic transforme l'étape en échec en ticket de bug Jira, Linear ou Azure DevOps, avec captures d'écran et résultats attendus et obtenus.
- Effort de mise à jour. Les heures passées à modifier les tests après chaque release.
- Temps de relecture. Les heures passées à lire les tests générés et les réparations. Une suite scriptée affiche zéro ici, alors comptez-le honnêtement du côté de l'IA.
- Coût total. La licence, plus tout ce qui précède, sur les deux ou trois ans de vie de la suite. Un framework scripté ne coûte rien en licence et très cher en personnes.
Pour juger si vos tests end-to-end sont fiables, rassemblez quatre types de preuves :
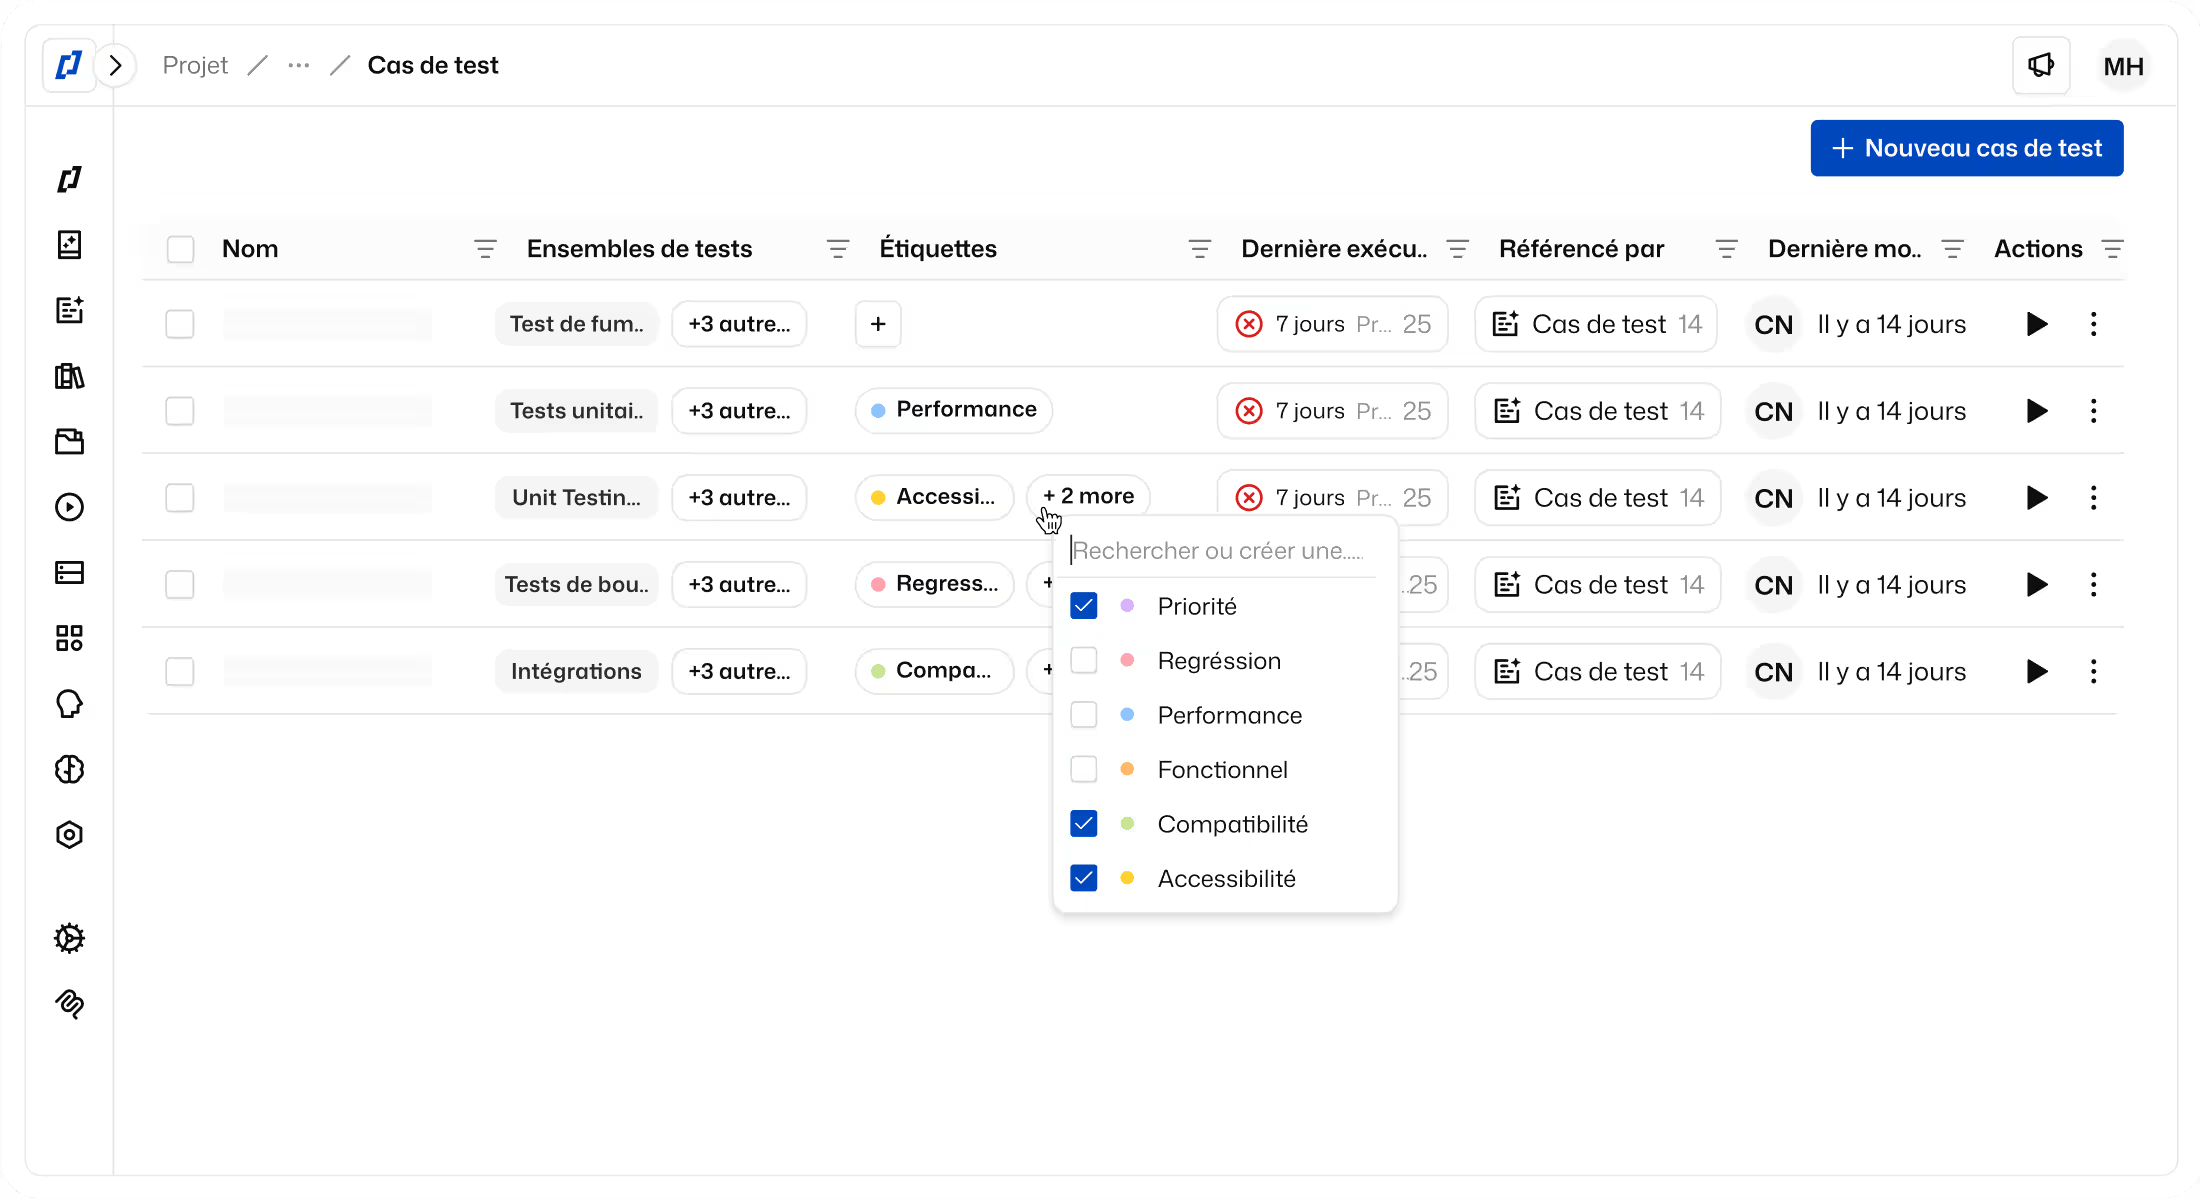
- Parcours pris en charge. Listez vos dix parcours les plus importants et confirmez que chacun s'exécute du début à la fin, y compris les passages délicats : envoi de fichiers, pages de paiement tierces, connexion.
- Résultats des réexécutions. Lancez dix fois la même suite sur un build inchangé. Tout test qui passe puis échoue est flaky. Nous annonçons un taux d'exécutions flaky inférieur à 0,5 %, et ce test vous dira si votre application obtient le même résultat.
- Taux d'échec. Parmi les échecs de l'essai, distinguez les vrais bugs des problèmes de test.
- Historique de maintenance. Un journal de chaque réparation et de chaque modification manuelle sur au moins deux releases. Nous affichons chaque étape réparée dans l'exécution et nous suivons les taux de réussite et les tests réparés automatiquement, ce qui vous donne cet historique sans que personne tienne un tableur. Si un outil ne peut pas produire ce journal, vous ne pouvez pas auditer ce qu'il a réparé.
La plupart des équipes essaient un nouvel outil sur leur parcours le plus propre. Prenez plutôt celui qui a cassé votre dernière suite. Si un outil zéro code en vient à bout avec un non-développeur aux commandes, les cinq mesures ci-dessus régleront le reste.