TLDR
- Un test d’assurance qualité vérifie qu’un logiciel respecte le comportement attendu.
- Assurance qualité, contrôle qualité et test désignent trois pratiques différentes.
- Les 4 niveaux sont les tests unitaires, d’intégration, système et d’acceptation.
- Un test se classe selon son niveau, la visibilité du code et la nature du contrôle.
- Retrouvez tous les types de tests dans le tableau de synthèse.
Dans un projet logiciel, parler de test assurance qualité ne suffit pas toujours à désigner la même pratique. Un test d’assurance qualité peut renvoyer à près de 30 pratiques selon ce qui est vérifié, le niveau concerné ou les informations accessibles au testeur. Quand un développeur affirme que « les tests passent » et qu’un chef de projet indique que « l’application a été testée », ils ne parlent donc pas nécessairement des mêmes contrôles.
Pour les distinguer, nous allons classer les tests logiciels selon trois axes : leur niveau, la visibilité du code et la nature de ce qu’ils vérifient. Un tableau de synthèse permettra ensuite de comparer rapidement les principaux types de tests.
Assurance qualité, contrôle qualité, test : trois choses différentes
L’assurance qualité (Quality Assurance ou QA) agit sur le processus pour prévenir les défauts. Le contrôle de la qualité (Quality Control ou QC) évalue le produit livré, tandis que le test logiciel vérifie son comportement.
L’assurance qualité ne consiste donc pas à tester : elle organise les pratiques qui limitent l’apparition des défauts.
Où les tests se placent dans le cycle de développement
Les tests interviennent tout au long du cycle de développement des logiciels (SDLC) : les exigences définissent le comportement attendu, la conception prépare l’architecture, le développement produit le code, les tests vérifient son fonctionnement, le déploiement le met à disposition et la maintenance accompagne ses évolutions.
Le principe du shift-left consiste à tester le plus tôt possible dans ce cycle. Plus un défaut est détecté tôt, moins sa correction mobilise de temps et de ressources, puisqu’il n’a pas encore affecté les phases suivantes.
Les tests poursuivent cinq objectifs :
- vérifier la conformité aux exigences ;
- détecter les défauts avant l’utilisateur ;
- sécuriser les évolutions du logiciel ;
- fournir des résultats pour décider d’une mise en production ;
- documenter le comportement attendu de l’application.
Les tests participent donc à la qualité du logiciel sans garantir l’absence totale de bugs. Tester montre la présence de défauts, jamais leur absence : c’est le premier des sept principes du test logiciel définis par l’ISTQB, auxquels nous reviendrons dans la FAQ.
Cette organisation du cycle permet aussi d’auditer votre dispositif qualité et d’identifier les contrôles à renforcer avant qu’un défaut n’atteigne la production.
On classe les tests selon trois axes indépendants : le niveau, la visibilité du code et la nature de ce qu’on vérifie. Un même test appartient donc aux trois classifications.
Les 4 niveaux de test
Les 4 niveaux de test correspondent au périmètre du logiciel vérifié, du composant isolé jusqu’à la validation métier de l’application complète.
1. Tests unitaires
Les tests unitaires vérifient une fonction, une méthode ou une classe de manière isolée. Ils sont généralement écrits par les développeurs pendant le développement. Un test unitaire peut, par exemple, vérifier qu’une fonction calcule correctement la TVA pour plusieurs montants et taux.
2. Tests d’intégration
Les tests d’intégration contrôlent les échanges entre plusieurs composants ou services. Ils vérifient que des éléments fonctionnels séparément communiquent correctement une fois associés. Un scénario peut tester l’appel d’une application à une API de paiement et le traitement de sa réponse.
3. Tests système
Les tests système évaluent l’application complète dans un environnement représentatif de son utilisation réelle. Ils vérifient le comportement du système dans son ensemble, avec ses composants, ses interfaces et ses dépendances, avant sa mise à disposition des utilisateurs.
4. Tests d’acceptation
Les tests d’acceptation, ou UAT (User Acceptance Testing), vérifient que le logiciel satisfait les besoins métier et les critères d’acceptation définis. Cette validation est réalisée par l’utilisateur, le client ou ses représentants avant d’autoriser la livraison.
La pyramide des tests
La pyramide des tests recommande une base importante de tests unitaires rapides, complétée par des tests d’intégration, puis par un nombre plus réduit de tests de bout en bout. Plus un test remonte dans la pyramide, plus son périmètre s’élargit et son exécution devient généralement coûteuse.
Le contre-modèle est la pyramide inversée : beaucoup de tests E2E fragiles et peu de tests unitaires. La suite devient alors plus lente à exécuter et plus lourde à maintenir.
Boîte blanche, boîte noire, boîte grise
Les niveaux indiquent à quelle échelle on teste ; la boîte blanche, noire ou grise indique avec quelles informations le test est réalisé.
En boîte blanche, le test de couverture du code mesure notamment les lignes ou branches exercées. D’autres techniques examinent directement la structure interne : test de trajectoire, test de boucle, test de flux de données ou test de débit de contrôle. Elles servent à vérifier différents chemins d’exécution du code source.
La boîte noire constitue le mode courant des tests fonctionnels et des tests E2E : le résultat est vérifié sans tenir compte de l’implémentation. La boîte grise se situe entre les deux, avec une connaissance partielle de l’architecture ou des données.
Un test unitaire est presque toujours réalisé en boîte blanche, tandis qu’un test d’acceptation est presque toujours conduit en boîte noire.
Tests fonctionnels et tests non fonctionnels
Les tests fonctionnels répondent à une question : le logiciel fait-il ce qu’il doit faire ? Les tests non fonctionnels vérifient plutôt s’il le fait correctement, notamment en matière de performance, de sécurité, de compatibilité ou d’accessibilité.
Les tests non fonctionnels constituent souvent un angle mort des dispositifs QA. Une équipe peut couvrir correctement les fonctionnalités attendues tout en négligeant la performance, la sécurité ou la compatibilité jusqu’au premier incident en production.
Les tests spécialisés selon le contexte
- Tests mobiles : combinent émulateurs et appareils réels pour couvrir de nombreuses configurations et les comportements propres au matériel.
- Tests SaaS et multi-tenant : vérifient notamment que les données et actions d’un client restent isolées de celles des autres tenants.
- Tests de migration de données : contrôlent l’intégrité des données après une migration ou une reprise. Un test de conversion de données vérifie aussi que les valeurs conservent leur format, leur sens et leurs relations après transformation.
- Tests d’API : vérifient le contrat de l’API, ses réponses, ses codes d’erreur et la gestion du versionnement.
Tableau de synthèse des types de tests
Un même test peut appartenir à plusieurs classifications. Ce tableau situe les principaux types de tests selon leur niveau, la visibilité du code, leur nature et leur potentiel d’automatisation.
Tests manuels ou automatisés : comment choisir
La différence entre tests manuels et tests automatisés tient à leur mode d’exécution. Dans le premier cas, un testeur réalise les vérifications ; dans le second, un outil exécute les mêmes contrôles à partir de scénarios définis à l’avance. Le choix dépend surtout de la fréquence, de la stabilité et du coût d’exécution du test.
Automatiser les tests répétitifs et prévisibles
La non-régression est prioritaire : les mêmes vérifications doivent être rejouées après chaque évolution du logiciel. Plus un test est répétitif, déterministe, fréquent et coûteux à refaire manuellement, plus son automatisation est pertinente.
Les parcours critiques exécutés à chaque release suivent la même logique. Pour approfondir ce choix, découvrez comment passer du test manuel à l’automatisation.
Garder l’humain lorsqu’un jugement est nécessaire
Les tests exploratoires, l’appréciation de l’ergonomie ou de l’expérience utilisateur nécessitent une interprétation humaine. Automatiser un parcours modifié chaque semaine ou un test exécuté une seule fois présente également peu d’intérêt : le temps consacré à son automatisation risque de dépasser le temps économisé.
Intégrer la maintenance au calcul
Un test automatisé n’est pas gratuit après sa création. Les scripts de test doivent évoluer avec l’application. Un parc de tests instables, ou flaky tests, finit par coûter plus cher qu’il ne rapporte en temps et en confiance.
Un symptôme revient souvent lors des audits : des tests désactivés « temporairement » parce qu’ils échouent trop souvent. Lorsque ces exceptions s’accumulent, l’automatisation des tests ne sécurise plus réellement les releases.
Le taux d’automatisation n’est donc pas un objectif en soi. Mieux vaut 40 % de tests fiables que 80 % de tests qu’il faut relancer trois fois avant d’obtenir un résultat exploitable.
Les tests dans un pipeline CI/CD, et en Agile
Dans un pipeline CI/CD, l’intégration continue impose d’exécuter chaque type de test au moment où son résultat reste utile. Les tests unitaires et les smoke tests tournent à chaque commit, les tests d’intégration à chaque merge et les tests de régression avant une release. Les tests non fonctionnels plus longs peuvent être exécutés la nuit.
Cette organisation permet de mettre en place des tests continus dans un pipeline sans ralentir inutilement le cycle de développement.
Des quality gates qui bloquent réellement le pipeline
Les quality gates fixent les conditions nécessaires pour poursuivre le déploiement sur le serveur d’intégration continue : seuil de couverture de code, réussite des tests critiques ou absence de défaut bloquant.
Cette règle perd tout son intérêt si les équipes peuvent la contourner. Un pipeline que l’on peut ignorer ne protège pas la mise en production. Une intégration CI/CD efficace doit faire de l’échec d’un test critique une condition de blocage.
Intégrer les tests au travail Agile
En Agile, la Definition of Done inclut les tests nécessaires pour considérer une fonctionnalité comme terminée. Le test ne constitue donc pas une phase isolée en fin de sprint : il accompagne le développement et la validation de chaque évolution.
En livraison continue, la fréquence des releases impose aussi une limite à la durée de la suite. Si une équipe déploie trois fois par jour, une non-régression qui demande six heures n’est plus compatible avec son rythme de livraison.
Construire une stratégie de test
Une stratégie de test efficace ne consiste pas à tout tester. Elle organise les contrôles selon les risques du projet et fixe les responsabilités, les critères de validation et les indicateurs à suivre.
- Prioriser le périmètre selon les risques. Commencez par les fonctionnalités dont la défaillance aurait le plus fort impact métier : paiement, authentification, données sensibles ou parcours générateurs de revenus.
- Définir les critères d’acceptation avant le développement. Les exigences du client doivent produire des résultats observables et vérifiables. Un critère qui ne peut pas être testé n’est pas un critère d’acceptation exploitable.
- Attribuer un responsable à chaque niveau. Les développeurs prennent en charge les tests unitaires, les équipes QA les tests système et d’acceptation, tandis que la revue implique l’ensemble de l’équipe. Chaque niveau doit avoir un responsable identifié.
- Organiser la gestion des défauts. Pour chaque anomalie, renseignez sa criticité, son délai cible et son rattachement à une exigence. Suivez aussi le taux de réouverture : une résolution des défauts mal documentée augmente le risque de voir le même problème réapparaître.
- Suivre quatre indicateurs. Mesurez la couverture des tests, les défauts échappés en production, la durée de la non-régression et la part de tests instables. Ces données permettent de vérifier si le dispositif qualité reste adapté aux risques du projet.
Une stratégie doit aussi être réévaluée lorsque le produit, l’équipe ou le rythme de livraison évolue. Vous pouvez auditer votre dispositif qualité pour identifier les contrôles devenus insuffisants ou trop coûteux.
Outils et frameworks : par catégorie
Les outils de test répondent à des fonctions différentes. Plutôt que de comparer des marques, identifiez la catégorie nécessaire à chaque étape de votre dispositif.
- Frameworks d’exécution : les frameworks de test pilotent un navigateur ou interrogent une API afin d’exécuter les scénarios dans l’environnement applicatif ciblé. Le choix dépend du type de test et de l’architecture du logiciel. Pour aller plus loin, comparez les frameworks d’automatisation web.
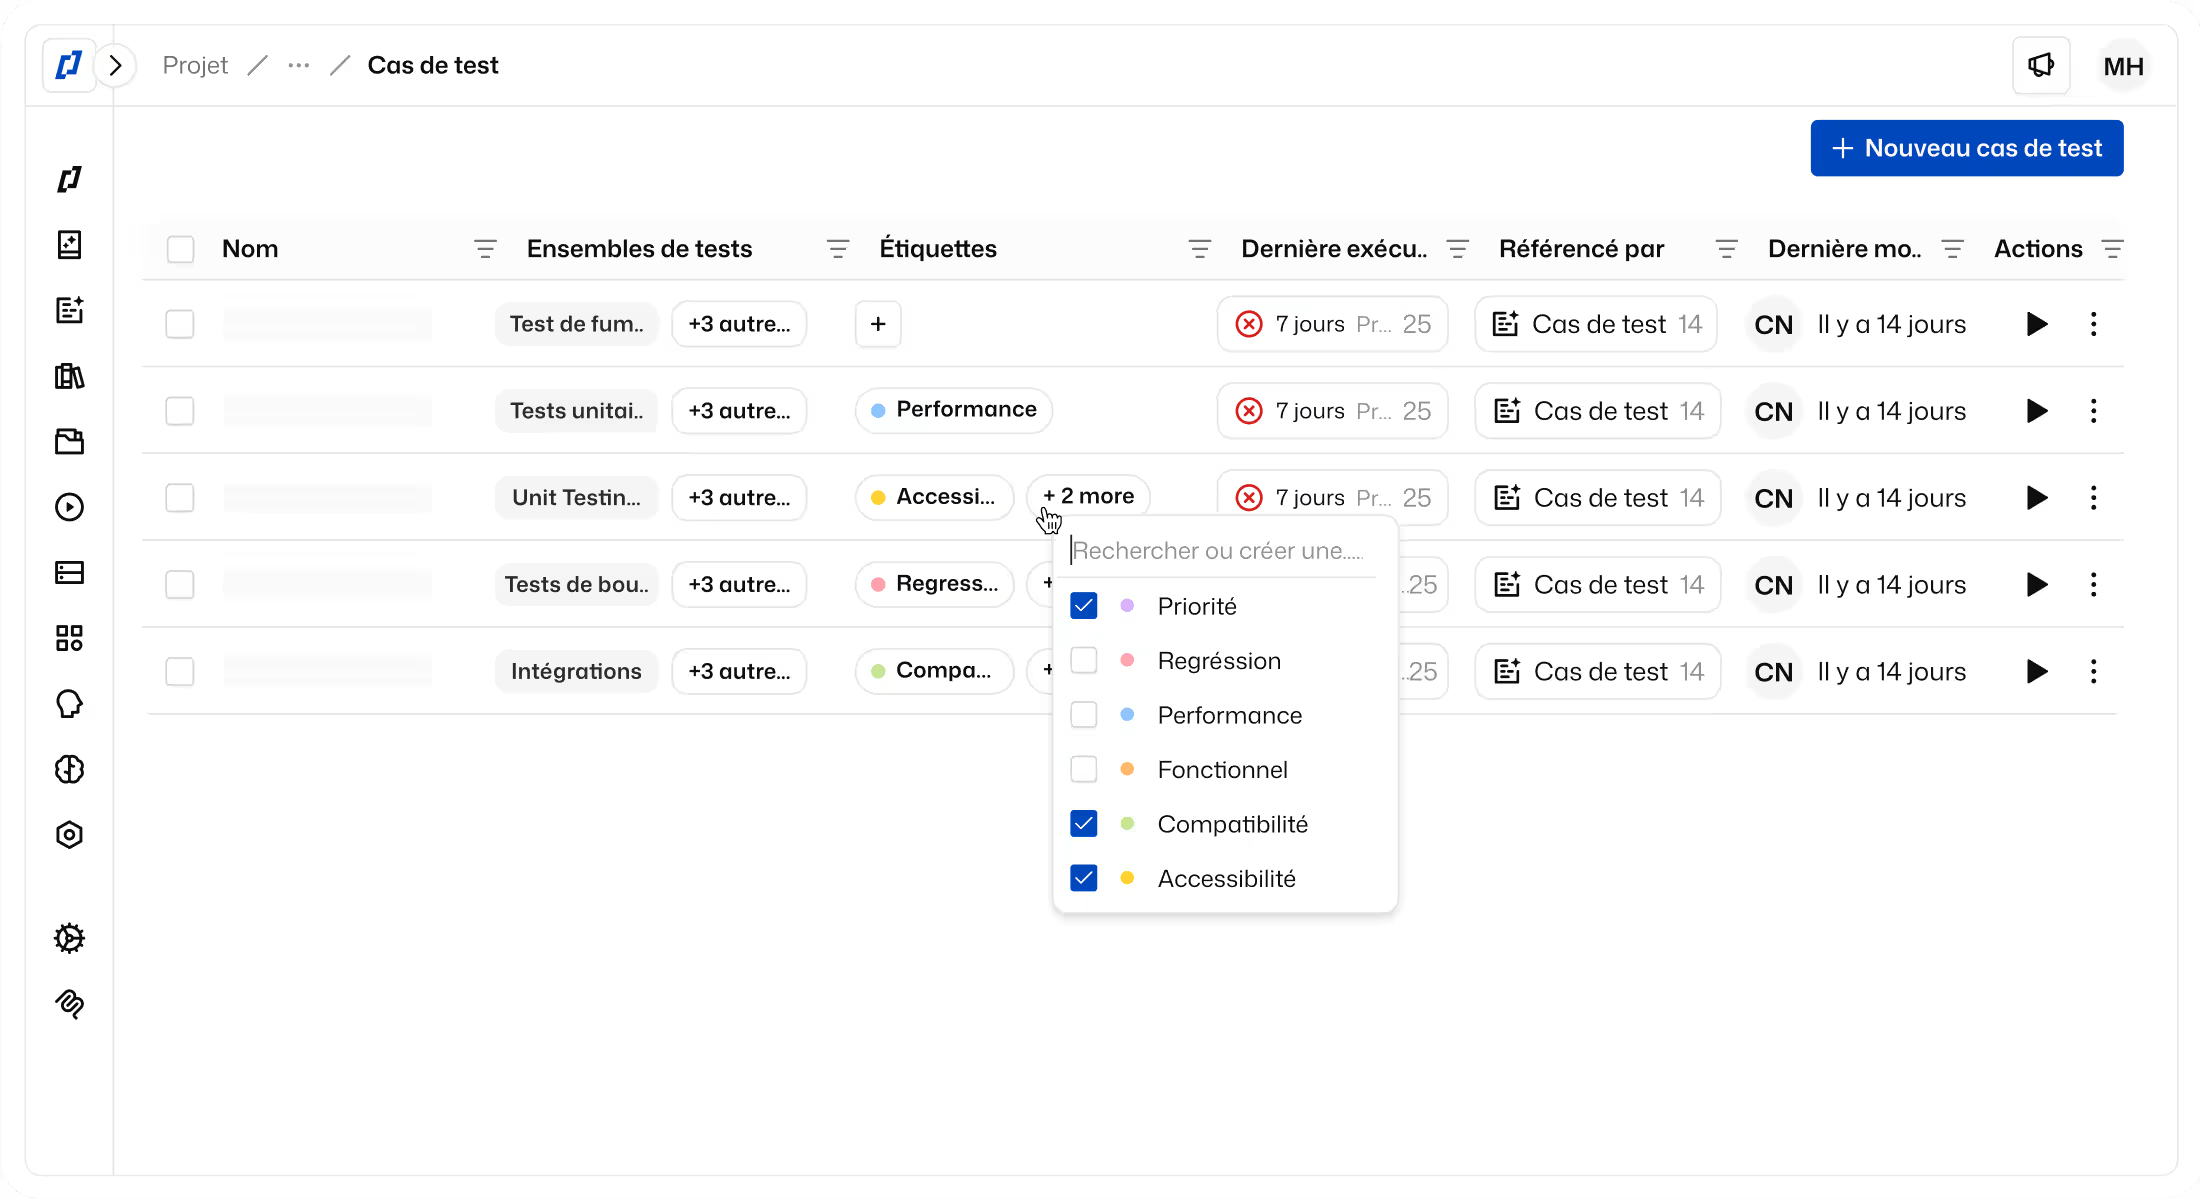
- Gestion des tests et ALM : centralisent les cas de test, les exécutions, les résultats et leur traçabilité avec les exigences. Une sélection d’outils de test QA permet d’identifier les fonctions utiles à votre organisation.
- Plateformes d’automatisation par IA : génèrent et maintiennent des tests afin de réduire le travail consacré aux scripts. Thunders permet notamment de créer des tests auto adaptatifs à partir du comportement attendu, sans dépendre de sélecteurs figés.
- CI et orchestration : déclenchent les suites de tests dans le pipeline et appliquent les règles de validation avant une livraison.
Pour passer l’automatisation à l’échelle, le meilleur critère de choix n’est pas le nombre de fonctionnalités disponibles, mais le coût de maintenance de l’outil et de ses tests sur deux ans.
Ce que les tests apportent, concrètement
Les bénéfices d’un test d’assurance qualité se mesurent dans les résultats du projet, pas dans le nombre de cas de test exécutés. Ces indicateurs relient directement les tests à la qualité des produits livrés.
- Moins de défauts échappés en production. Suivez le nombre de défauts détectés par les utilisateurs après une release et leur criticité. Leur évolution renseigne sur l’efficacité réelle des tests avant la mise en production.
- Des releases plus fréquentes. Une suite de tests fiable fournit des critères objectifs pour autoriser ou bloquer une livraison. La décision repose sur des résultats plutôt que sur une appréciation individuelle du risque.
- Un coût de correction plus bas. Un défaut détecté pendant le développement mobilise moins de ressources qu’un incident déjà présent en production, où il faut diagnostiquer le problème, corriger le logiciel et gérer ses conséquences.
- Une base factuelle pour décider. Les résultats des tests documentent l’état du logiciel, les défauts connus et les risques résiduels. Les arbitrages de mise en production reposent alors sur des faits plutôt que sur l’avis de la personne la plus convaincante.
- Des preuves pour les clients exigeants. Dans les secteurs soumis à des exigences fortes, les rapports de test, résultats et historiques de correction fournissent des preuves documentées lors d’un questionnaire client ou d’un audit.