TLDR
- Une refonte de l'interface et une nouvelle modale ont cassé 45 de nos 69 tests E2E en pleine release.
- Le bruit → init script. Un seul script a fermé la modale pour tous les tests, ce qui a éliminé environ 90 % des échecs.
- Les parcours modifiés → MCP. Un seul prompt a mis à jour en masse les tests concernés, et un ingénieur a corrigé à la main les 2 ou 3 restants.
- Tout le reste → self-healing. Les tests dont les éléments avaient seulement changé de place ont continué à passer.
- Réparé en une heure, et la release est partie à l'heure prévue.
Nous testons Thunders avec Thunders. Évidemment. Thunders est une plateforme d'automatisation des tests par IA, et notre propre suite de tests de bout en bout tourne sur notre produit, comme première étape de chaque release quotidienne. Cette suite est le dernier rempart entre un merge et un rollback.
Notre dernière release a réorganisé la barre latérale de l'application. Le menu des projets, le menu des organisations, les contrôles utilisateur, les paramètres de langue : tout a bougé, et plusieurs entrées ont rejoint une nouvelle section « Configure ». La même release lançait Inbox, annoncée par une notification plein écran à la première ouverture de l'application.
Ce jour-là, la suite est passée au rouge. Largement au rouge.
Nous avions prévu quelques étapes de navigation cassées. Nous n'avions pas prévu la modale. Voici la réparation telle qu'elle s'est déroulée, dans l'ordre, et les trois choses qui l'ont fait tenir en une heure au lieu du reste de la semaine.
45 tests E2E sur 69 en échec, pour une seule raison
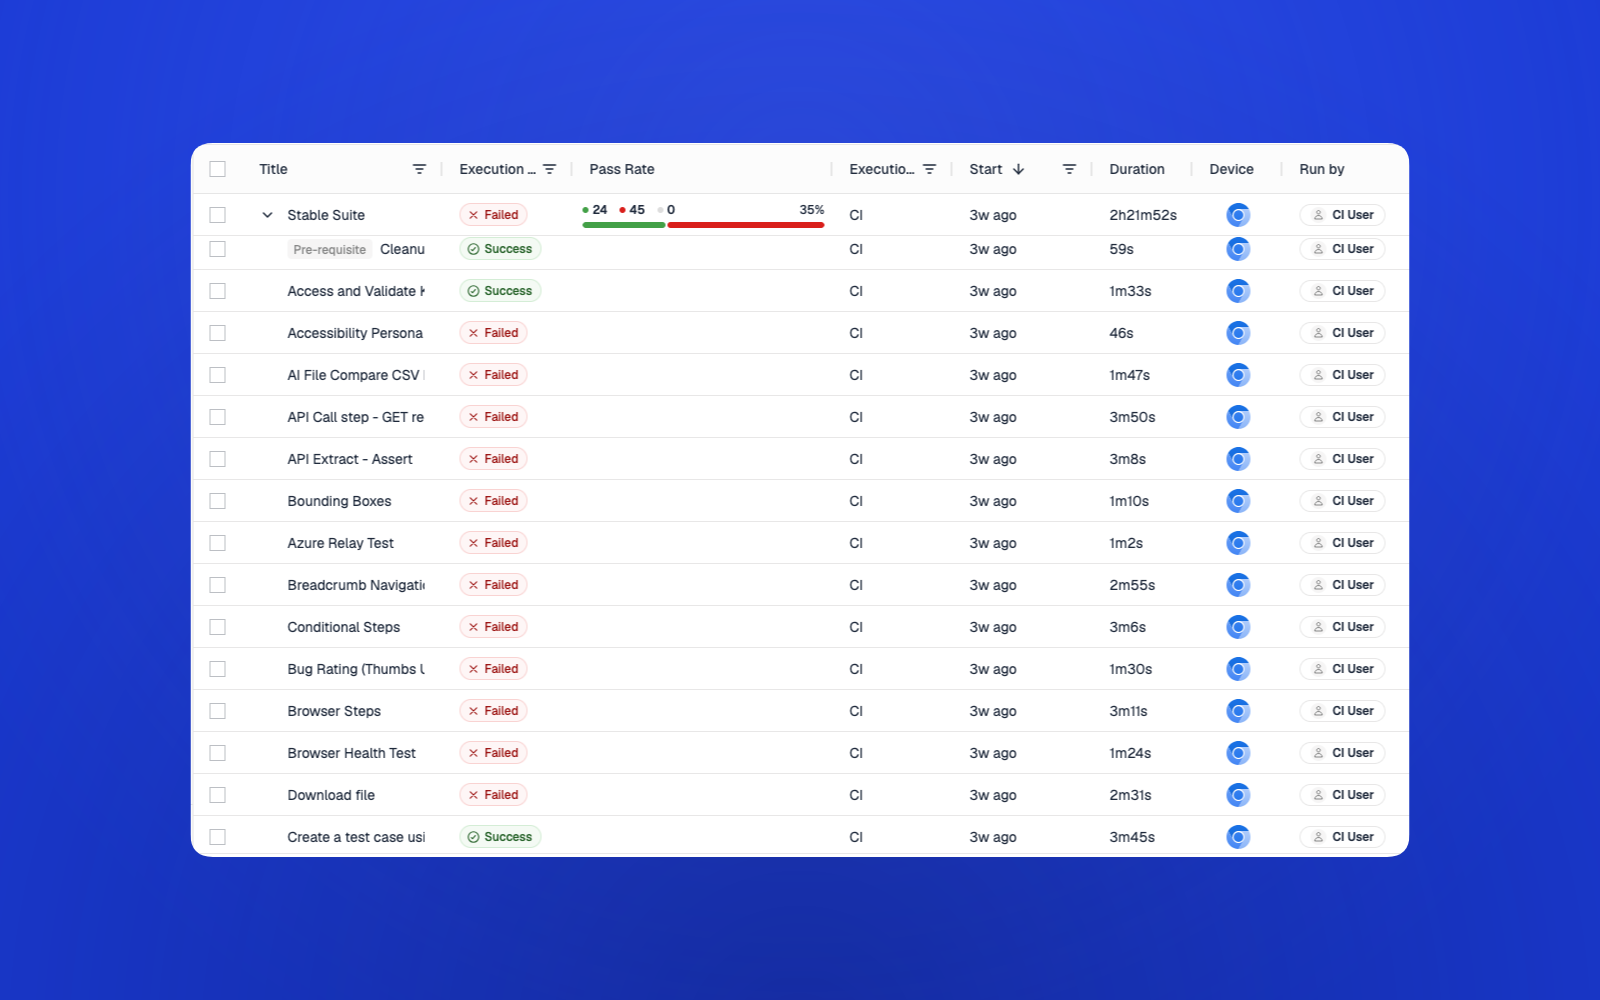
L'annonce d'Inbox s'affichait par-dessus l'application et bloquait toute interaction avec ce qui se trouvait en dessous, barre latérale comprise. Sur nos 69 tests de bout en bout, 45 ont échoué parce qu'ils passent par la barre latérale dès leurs premières étapes. Et ils échouaient pour une raison qui n'avait rien à voir avec ce qu'ils testaient.
La solution évidente est la mauvaise. Ajouter une étape « fermer la notification » au début de chaque test, livrer, passer à autre chose. Ça marche parfaitement. C'est d'ailleurs ce que votre LLM préféré aurait fait à vos 45 tests. Le résultat : une étape glissée dans 45 parcours où elle n'a rien à faire, et le jour où l'annonce disparaît, il faut la retirer des 45. Ces étapes s'accumulent. Six mois plus tard, plus personne ne sait lesquelles servent encore à quelque chose.
Les init scripts : réparer l'environnement, pas la suite
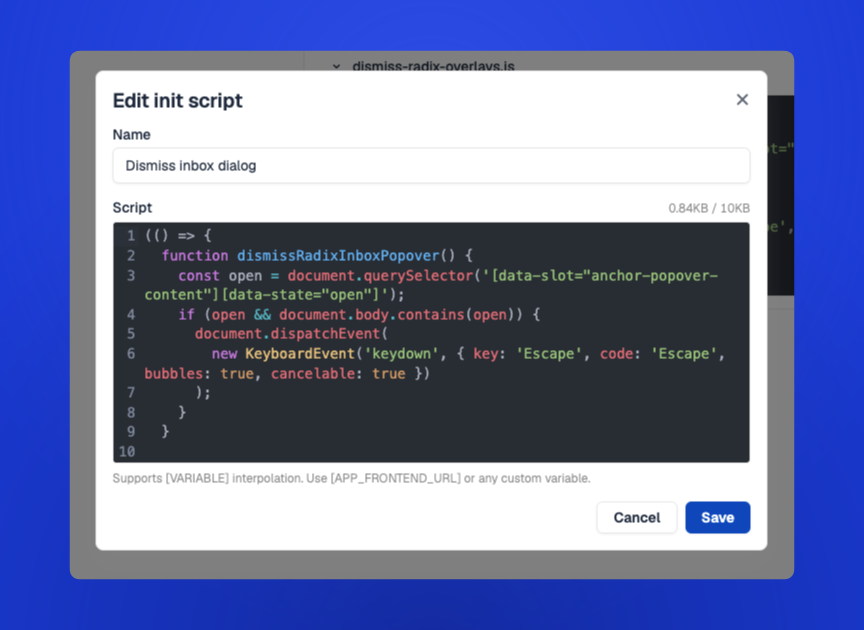
Thunders propose des init scripts : du JavaScript injecté au démarrage de l'environnement de test, avant le chargement de la page. À chaque exécution, sur chaque nouvelle page, de façon systématique, au bon moment.
Nous en avons écrit un qui ferme l'annonce d'Inbox dès qu'elle apparaît. Un seul script, appliqué à tout l'environnement, modifié directement en ligne : pas de PR, pas d'une heure de CI, testable immédiatement. Et aucun test modifié. Cela a éliminé environ 90 % des échecs.
Un init script est un script JavaScript qui s'exécute avant le chargement de chaque page pour mettre le navigateur dans l'état attendu par le test. Configuré par environnement, il peut contourner des captchas, activer des feature flags, désactiver l'analytics, ou empêcher l'affichage de bannières et de pop-ups.
Une mise en garde, car l'outil est facile à surutiliser. Un init script sert à éliminer le bruit. Si une modale fait partie de l'expérience produit que vous voulez vérifier, la supprimer cache un vrai trou dans votre couverture au lieu de réparer un test cassé. La bonne question à se poser : un utilisateur considérerait-il cet élément comme faisant partie du parcours ?
Pour nous, la réponse était non. Une invitation à découvrir une fonctionnalité qu'on vient de lancer, c'est du bruit pour un test qui porte sur le changement de projet.
Le MCP : mettre à jour les tests qui ont vraiment changé
Voici le prompt exact que nous avons utilisé :
markdown
Notre barre latérale a été réorganisée lors de la dernière release. Le changement de projet ne se fait plus depuis le menu des projets : l'utilisateur ouvre désormais le **menu de l'organisation**, clique sur **Configure**, puis choisit le projet.

Dans le projet <nom-du-projet> :
	1. Récupère la dernière exécution et liste tous les cas de test qui ont échoué sur une étape impliquant le menu de l'organisation ou des projets.
	2. Pour chacun, lis les étapes et repère où le parcours suppose l'ancienne navigation (un clic sur l'organisation ou sur le menu des projets, suivi directement de la sélection d'un projet).
	3. Remplace cette séquence par le nouveau parcours : ouvrir le menu de l'organisation → cliquer sur Configure → sélectionner le projet. Insère l'étape Configure manquante au lieu de réécrire tout le test, et ne touche à aucune assertion ni à aucune des étapes suivantes.
	4. Ne modifie rien d'autre. Si un test échoue pour une autre raison, ou si ses étapes ne correspondent pas à ce schéma, passe-le et liste-le à la fin pour qu'on le corrige à la main.

Avant d'appliquer quoi que ce soit, montre-moi la liste des cas de test que tu vas modifier avec un avant/après des étapes, et attends mon feu vert.
Une fois la modale écartée, il restait un petit groupe de tests en échec. C'étaient les vraies régressions : des parcours qui avaient réellement changé.
La refonte avait modifié la façon de changer de projet. Au lieu de choisir un projet là où se trouvait le menu, il faut désormais passer par l'organisation et le nouveau parcours de navigation. Certains tests cliquaient sur l'organisation et ne trouvaient jamais les projets attendus.
Ces tests avaient besoin de vraies modifications, et la modification avait toujours la même forme : ajouter l'étape de navigation vers Configure, puis continuer vers l'élément déplacé. Nous avons utilisé le serveur MCP de Thunders pour identifier les tests concernés et leur appliquer cette mise à jour en un seul prompt, sans les ouvrir un par un. Deux ou trois tests ne correspondaient pas au schéma, et un ingénieur les a corrigés à la main.
La répartition des rôles mérite d'être précise. L'init script a traité les échecs qui n'en étaient pas vraiment. Le MCP a traité ceux qui en étaient. Aucun des deux outils ne remplace l'autre, et se tromper d'outil, c'est transformer un travail d'une heure en travail de trois jours.
Les tests self-healing : pourquoi la majeure partie de la suite n'a rien remarqué
Vu l'ampleur des changements dans la barre latérale, nous nous attendions à une longue série d'étapes cassées. Elle a été courte.
Le cœur de la barre latérale était toujours là. Beaucoup d'éléments n'avaient pas bougé. Et rien n'avait changé dans le comportement du produit (changer de projet changeait toujours de projet). Thunders résout chaque étape à partir de l'intention de l'action plutôt qu'à partir d'un sélecteur figé : les éléments qui avaient changé de place ont été retrouvés, et les tests ont continué.
Les tests qui ont eu besoin d'un humain sont ceux dont le parcours lui-même avait changé : un élément était passé sous Configure, donc l'utilisateur doit désormais faire quelque chose de nouveau pour l'atteindre. C'est la bonne ligne de partage. Un test doit casser quand le chemin de l'utilisateur change. Il ne doit pas casser parce qu'une div a bougé.
Une heure, pas une semaine
Les régressions ont été corrigées pendant la release, en une heure environ, et la release est partie à l'heure prévue.
Quand une suite passe au rouge à grande échelle, le réflexe est d'ouvrir les tests un par un. C'est presque toujours la mauvaise approche. Dans notre cas, cela aurait coûté des jours (et nous livrons tous les jours). Cela aurait aussi laissé une étape de fermeture enfouie dans les 45 parcours que nous maintenons.
Commencez par classer les échecs. Tout ce qui vient d'un élément extérieur au parcours se traite une seule fois, au niveau de l'environnement. Tout ce qui vient d'un parcours modifié se met à jour en masse. Ce qui reste est généralement assez réduit pour être corrigé à la main en dix minutes.
La majeure partie de la suite n'a pas besoin d'être touchée. C'est un peu tout l'intérêt d'en avoir une.